AlexNet: ගැඹුරු ඉගෙනීමේ (deep learning) යුගය ඇරඹූ 2012 වසරේ ස්නායු ජාලය (neural network)
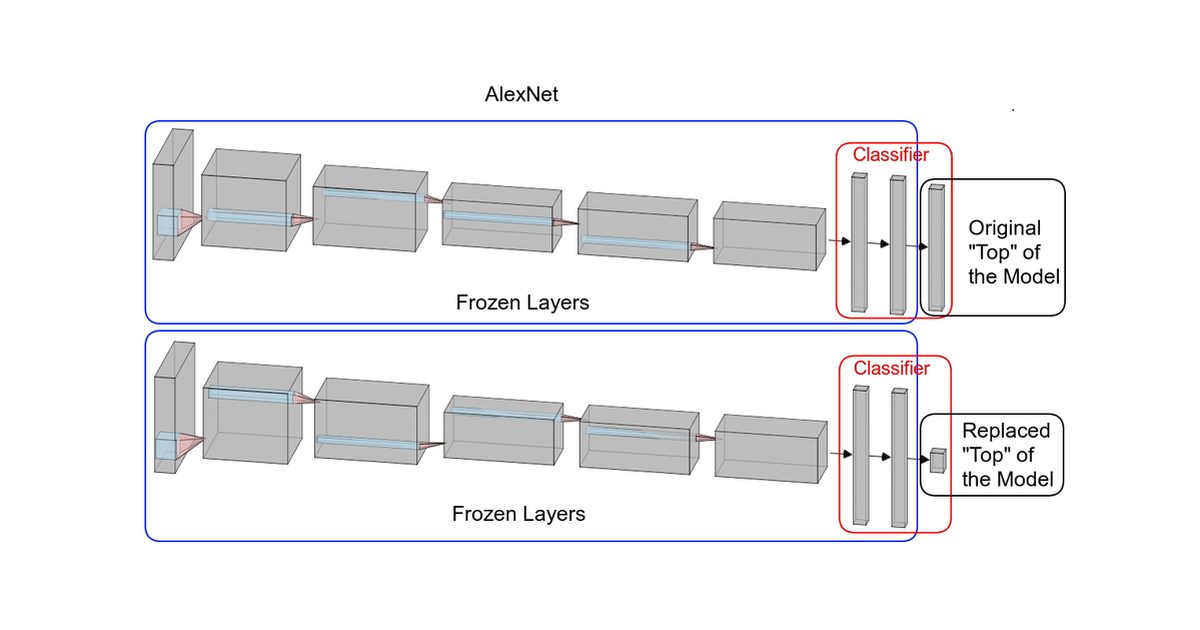
AlexNet ස්ථර පදනම් කරගත් convolutional ජාලයක රූප සටහන (classifier එක ප්රතිස්ථාපනය කර ඇත); නිදර්ශනයකි, 2012 මුල් ගෘහ නිර්මාණය නොවේ. රූප සටහන: Daniel Voigt Godoy, CC BY 4.0, Wikimedia Commons හරහා.
2012 සැප්තැම්බර් 30 වන දින ImageNet Large Scale Visual Recognition Challenge (ILSVRC) තරගය ජය ගත් සංවෘතීය ස්නායු ජාලය (convolutional neural network) AlexNet යි. කෘත්රිම බුද්ධියේ (artificial intelligence) ගැඹුරු ඉගෙනීම (deep learning) ප්රධාන ධාරාවට ඇතුළු වූ මොහොත ලෙස මෙම ජයග්රහණය බොහෝ දෙනා සලකති.
Toronto විශ්වවිද්යාලයේ (University of Toronto) Alex Krizhevsky විසින්, සග ශාස්ත්රපති ශිෂ්ය Ilya Sutskever සහ ඔහුගේ ආචාර්ය මණ්ඩල අධීක්ෂක (PhD supervisor) Geoffrey Hinton සමඟ එක්ව මෙම ආකෘතිය නිර්මාණය කරන ලදී. "SuperVision" කණ්ඩායම ලෙස තරග වූ ඔවුන්ගේ ඇතුළත් කිරීම, ප්රථිමා වස්තු කාණ්ඩ 1,000 කට වර්ගීකරණය කිරීමේදී top-5 දෝෂ අනුපාතය (top-5 error rate) 15.3% ක් ලෙස සටහන් කළේය. දෙවන ස්ථානයට පත් අයට වඩා ප්රතිශත ලක්ෂ්ය 10.8 කින් වැඩි වූ මෙම පරතරය ක්ෂේත්රය එතෙක් දැක නොතිබුණි.
පරාමිතීන් (parameters) මිලියන 60 ක් සහ නියුරෝන (neurons) 650,000 ක් සහිත මෙම ජාලය ස්ථර (layers) අටකින් සමන්විත විය: පළමු සංවෘතීය ස්ථර (convolutional layers) පහ - ඒවායින් සමහරක් අනුගමනය කළ max-pooling ස්ථර - සහ අවසාන සම්පූර්ණ සම්බන්ධිත ස්ථර (fully connected layers) තුන. ආකෘතිය එක් graphics card එකක GB 3 මතකයට (memory) නොගැලපුණු බැවින්, එය Nvidia GTX 580 GPU දෙකකට බෙදා තිබුණි - නිකුත් වූ විට එක් එක් කාඩ්පත ඇමරිකානු ඩොලර් 500 ක් පමණ වූ - සහ ලේබල් කළ ප්රථිමා මිලියන 1.2 ක් මත දින පහක සිට හයක් දක්වා පුහුණු කරන ලදී. පුහුණු යන්ත්රය තිබුණේ Krizhevsky ගේ දෙමාපියන්ගේ නිවසේ ඔහුගේම නිදන කාමරයේය.
නිර්මාණ තේරීම් කිහිපයක් මෙම ප්රතිඵලය සාධ්ය කළේය. එවිට සම්ප්රදාය වූ tanh සහ sigmoid ශ්රිතවලට වඩා වේගයෙන් පුහුණු වූ ReLU සක්රියකාරක ශ්රිතය (ReLU activation function) AlexNet භාවිත කළේය; අධි-ගැලපීම (overfitting) මැඩපැවැත්වීමට dropout නියාමනය (regularization); අහඹු කප්පාදු සහ තිරස් පරාවර්තන (random crops and horizontal reflections) හරහා පුහුණු කට්ටලය 2,000 ගුණයකට වැඩි වර්ධනය කළ ක්ෂණික දත්ත වර්ධනය (data augmentation) යනාදීය. තරගය සඳහා, වෙන වෙනම පුහුණු කළ AlexNet හතක අනුමානයන්ගේ සාමාන්යය කණ්ඩායම ගත්තේය. CUDA සහ C++ වලින් cuda-convnet ලෙස ලියන ලද කේතය BSD බලපත්රයකින් (BSD licence) නිකුත් කරන ලද අතර, 2012 මුල් මූලාශ්ර කේතය (source code) 2025 මාර්තු මාසයේදී Computer History Museum විසින් නිල වශයෙන් නිකුත් කරන ලදී.
පෙර දශකය තුළ පරිපක්ව වූ සංවර්ධන තුනක් මත මෙම ජයග්රහණය පදනම් විය: 2007 සිට Fei-Fei Li විසින් ගොඩනගන ලද ImageNet දත්ත කට්ටලය - කාණ්ඩ 22,000 ක ලේබල් කළ ප්රථිමා මිලියන 14 කට වැඩි ප්රමාණයක්; Nvidia හි CUDA වේදිකාව හරහා පොදු අරමුණු GPU ගණනය (general-purpose GPU computing); ගැඹුරු ජාල පුහුණු කිරීමේ දියුණු කළ ක්රම. "නවීන AI හි මූලික අංග තුන පළමු වරට එක් වූ බැවින් එම මොහොත AI ලෝකයට බොහෝ සංකේතාත්මක විය" යැයි Li 2024 සම්මුඛ සාකච්ඡාවකදී කීවාය. 2012 European Conference on Computer Vision හිදී Yann LeCun මෙම ආකෘතිය "පරිගණක දැක්මේ ඉතිහාසයේ නිසැක හැරවුම් ලක්ෂ්යයක්" (an unequivocal turning point) ලෙස හැඳින්වීය.
පසුව ඇති වූ දේ කර්මාන්තයම නැවත හැඩගැස්වීය. Hinton, Sutskever සහ Krizhevsky ඉක්මනින් DNNresearch සමාගම ආරම්භ කර, එයත් AlexNet කේතයත් Google වෙත විකුණන ලදී. Sutskever පසුව OpenAI හි සහ-නිර්මාතෘවරයෙකු විය; Hinton 2024 භෞතික විද්යා නෝබෙල් ත්යාගය (Nobel Prize in Physics) දිනා, "මේක කරන්න ඕන කියලා Ilya හිතුවා, Alex ඒක වැඩ කළා, නෝබෙල් ත්යාගය මට ලැබුණා" යැයි හිනාවෙන් කීවේය. GoogLeNet, VGGNet (2014), ResNet (2015), EfficientNet (2019) වැනි ගැඹුරු අනුප්රාප්තික ආකෘතීන් AlexNet ඉක්මවන නිරවද්යතාවයකට ළඟා වූ අතර, SqueezeNet (2016), MobileNet (2017) වැනි කුඩා ආකෘතීන් සමාන බලය ජංගම දුරකථනවලට ගෙන ආවේය. 2025 මුල් භාගය වන විට මුල් පර්යේෂණ පත්රිකාව 198,000 කට වැඩි වරක් උදාහරණයට ලැබී තිබුණි (cited) - පළ කරන ලද වඩාත් බලගතු පරිගණක විද්යා පත්රිකාවලින් (computer science papers) එකක් ලෙස එය සැලකේ.